Kiến Trúc Mô Hình & Đánh Giá Thực Nghiệm
Quy trình nghiên cứu, huấn luyện và so sánh 3 thuật toán Machine Learning trên bộ dữ liệu Pima Indians Diabetes
1. Khảo Sát & Tiền Xử Lý Dữ Liệu Chống Rò Rỉ (Anti Data Leakage)
Đề tài sử dụng bộ dữ liệu chuẩn y khoa Pima Indians Diabetes Dataset từ Viện Quốc gia về Bệnh tiểu đường, Tiêu hóa và Bệnh thận (NIDDK - Hoa Kỳ), được chia sẻ trên Kaggle và UCI Machine Learning Repository.
🛡️ Quy trình chống rò rỉ dữ liệu (No Data Leakage):
- Xử lý giá trị 0 không hợp lý: Các chỉ số Glucose = 0 (5 mẫu) và BMI = 0 (11 mẫu) được quy đổi thành
NaNvì đây là dữ liệu bị thiếu ẩn. - Đóng gói Pipeline: Quá trình tính toán trung vị (SimpleImputer) và chuẩn hóa thang đo (StandardScaler) được tính toán chỉ trên tập Train (fit), sau đó đóng băng và chỉ áp dụng (transform) sang tập Test và môi trường Web.
2. Bảng So Sánh Hiệu Năng 3 Thuật Toán Trên Tập Kiểm Thử (154 Mẫu)
Mọi chỉ số đánh giá được tính toán từ quá trình chạy thực tế bằng thư viện scikit-learn, tuyệt đối không tạo số liệu giả lập:
| Thuật toán Machine Learning | Độ chính xác (Accuracy) | Độ chuẩn xác (Precision) | Độ nhạy (Recall) | F1-Score | ROC-AUC | Trạng thái lựa chọn |
|---|---|---|---|---|---|---|
| Logistic Regression | 70.78% | 59.57% | 51.85% | 55.45% | 78.63% | Mô hình đối sánh |
| Decision Tree Mô hình tối ưu | 79.87% | 70.91% | 72.22% | 71.56% | 81.44% | Đã triển khai Web |
| Random Forest | 75.97% | 67.35% | 61.11% | 64.08% | 81.46% | Mô hình đối sánh |
🎯 Lý do lựa chọn mô hình Decision Tree:
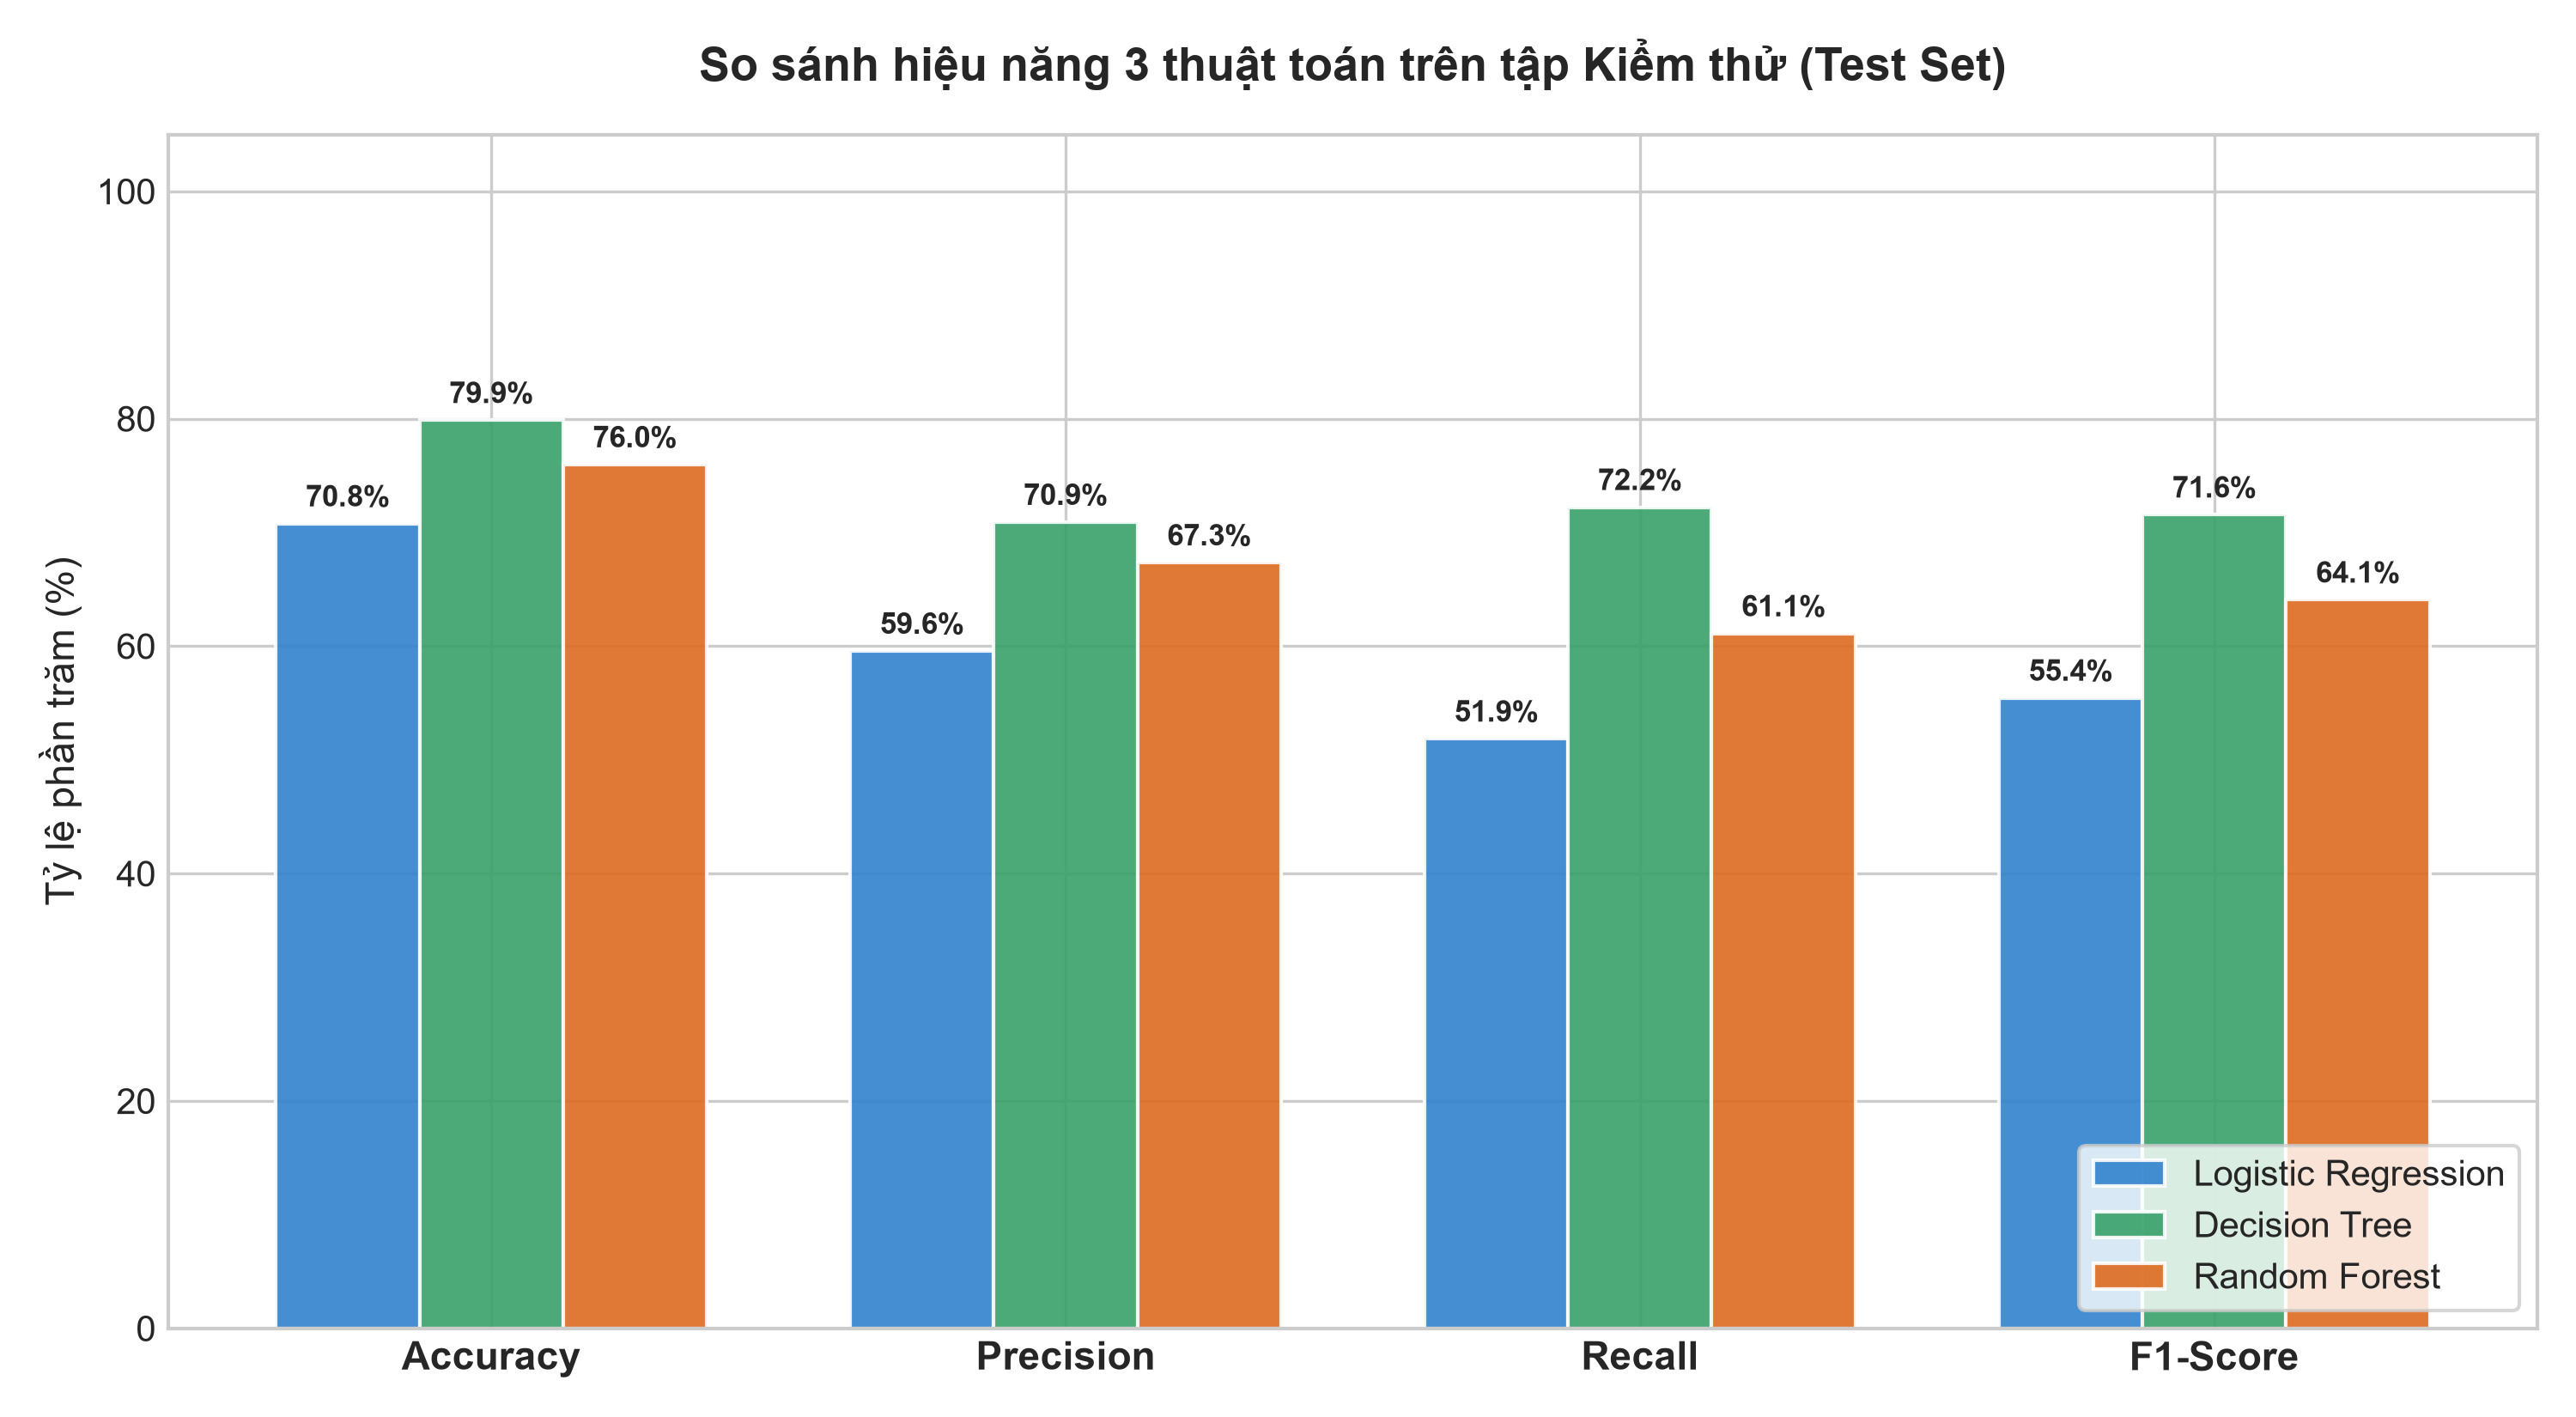
Trong sàng lọc y khoa, Recall (Độ nhạy) là chỉ số quan trọng nhất vì nó phản ánh tỷ lệ người thực sự có bệnh được mô hình phát hiện đúng, giảm thiểu ca âm tính giả (False Negative - bỏ sót bệnh nhân). Decision Tree đạt Recall 72.22% (vượt trội so với Logistic Regression 51.85% và Random Forest 61.11%) cùng với Accuracy 79.87% và F1-Score 71.56%, là mô hình hiệu quả nhất trên bộ 3 đặc trưng đầu vào.
3. Biểu Đồ Đánh Giá & Ma Trận Nhầm Lẫn (Confusion Matrix)
Các biểu đồ được sinh tự động từ quá trình thực nghiệm:
Biểu đồ so sánh 4 chỉ số hiệu năng
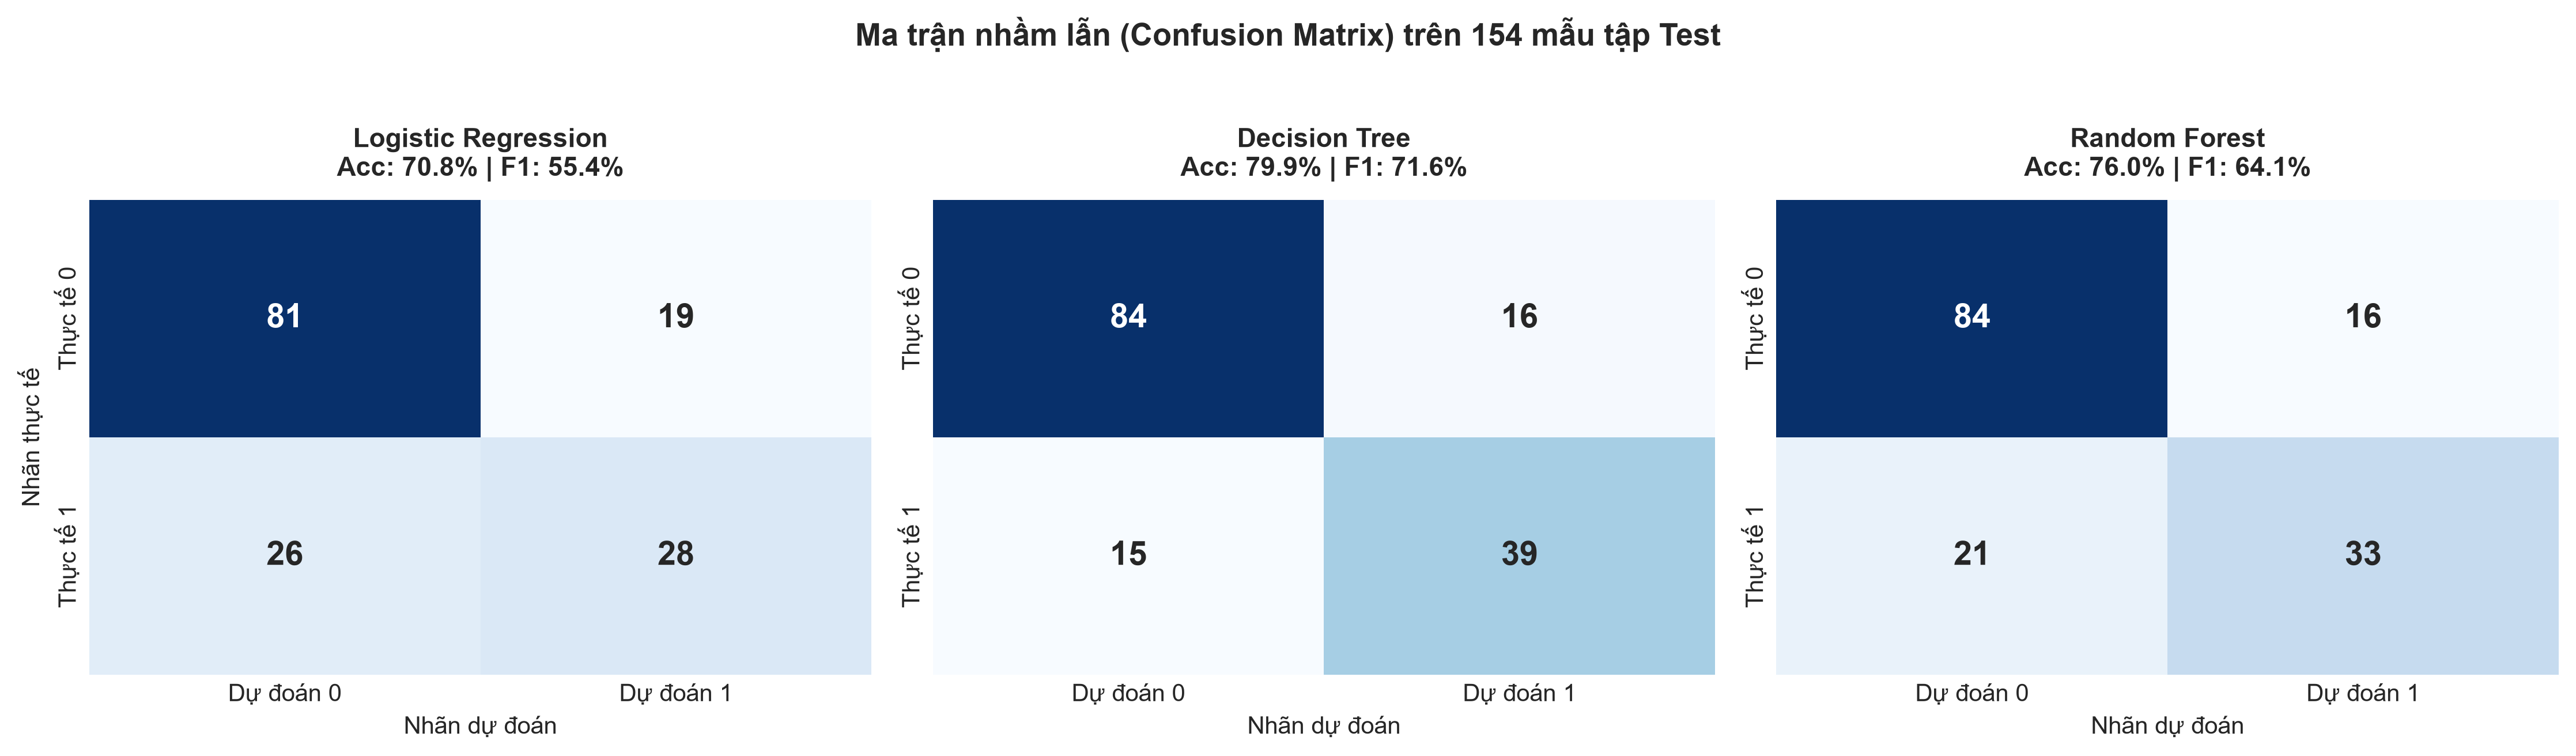
Ma trận nhầm lẫn (Confusion Matrix - 154 mẫu Test)
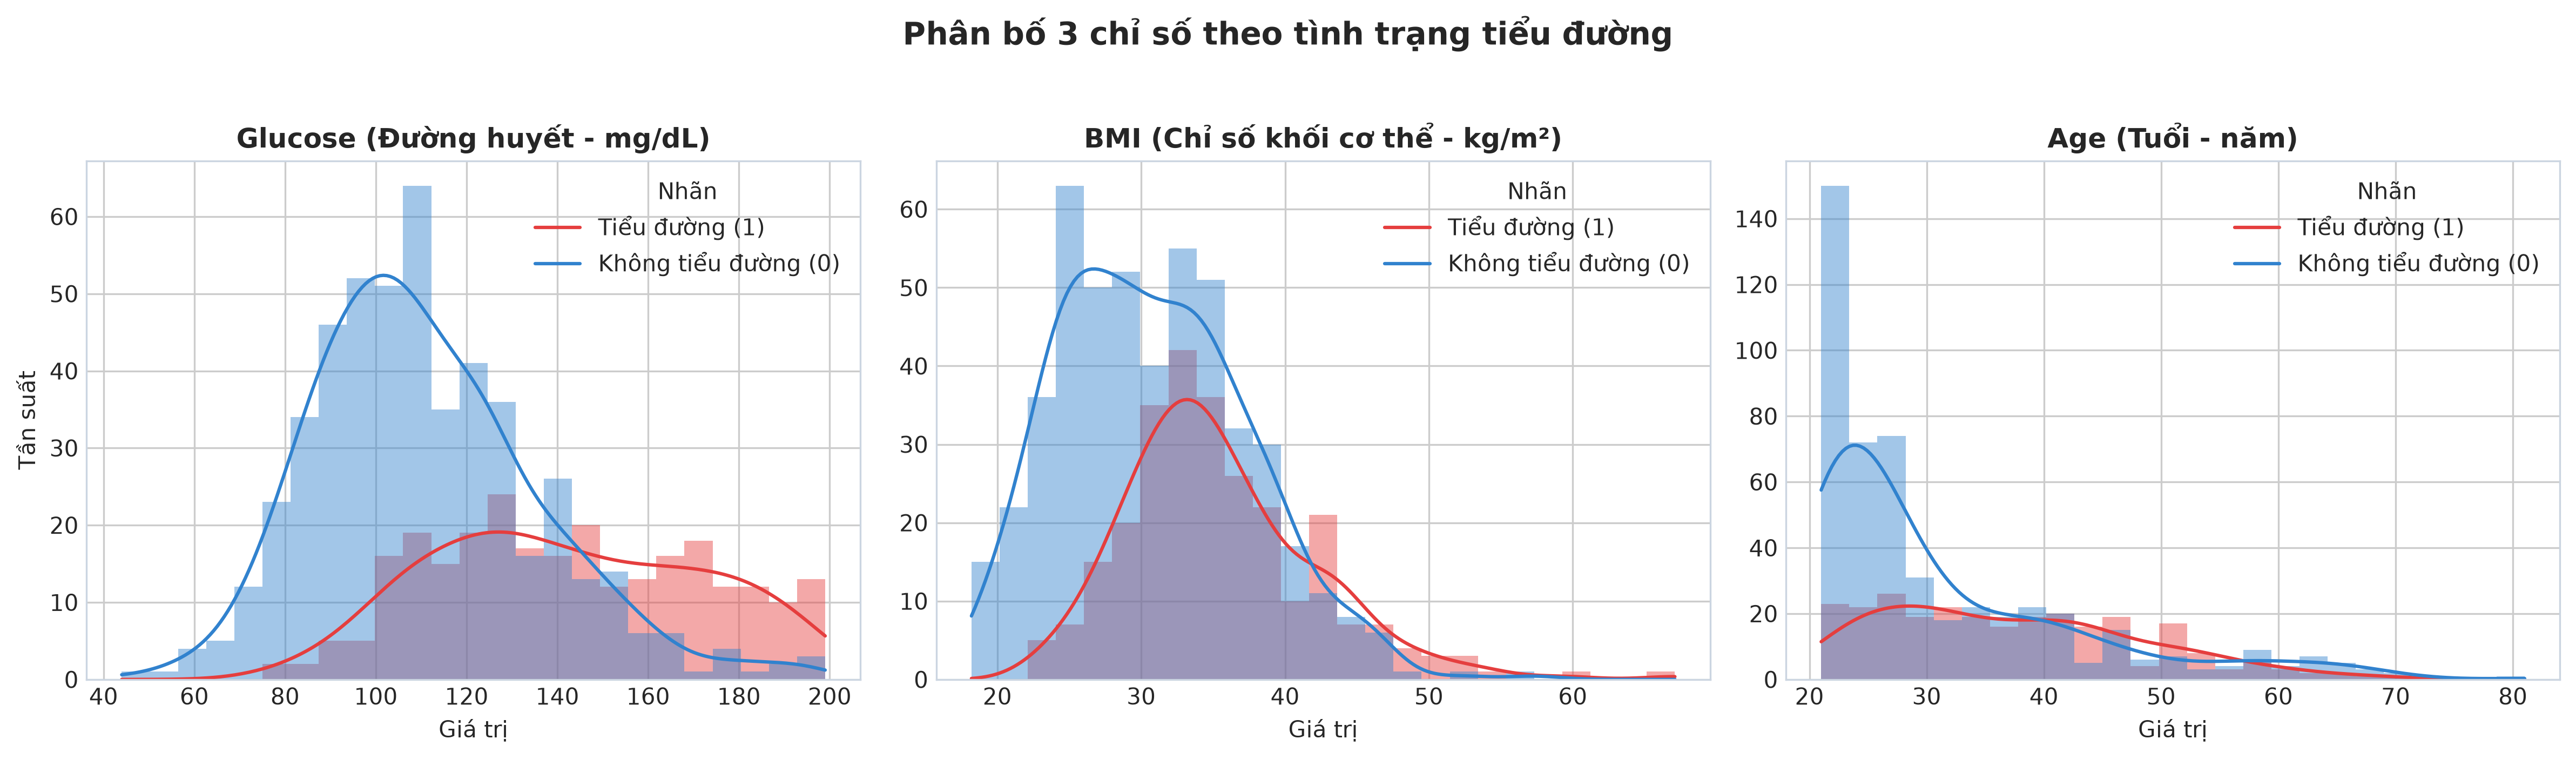
Phân bố 3 chỉ số theo tình trạng bệnh
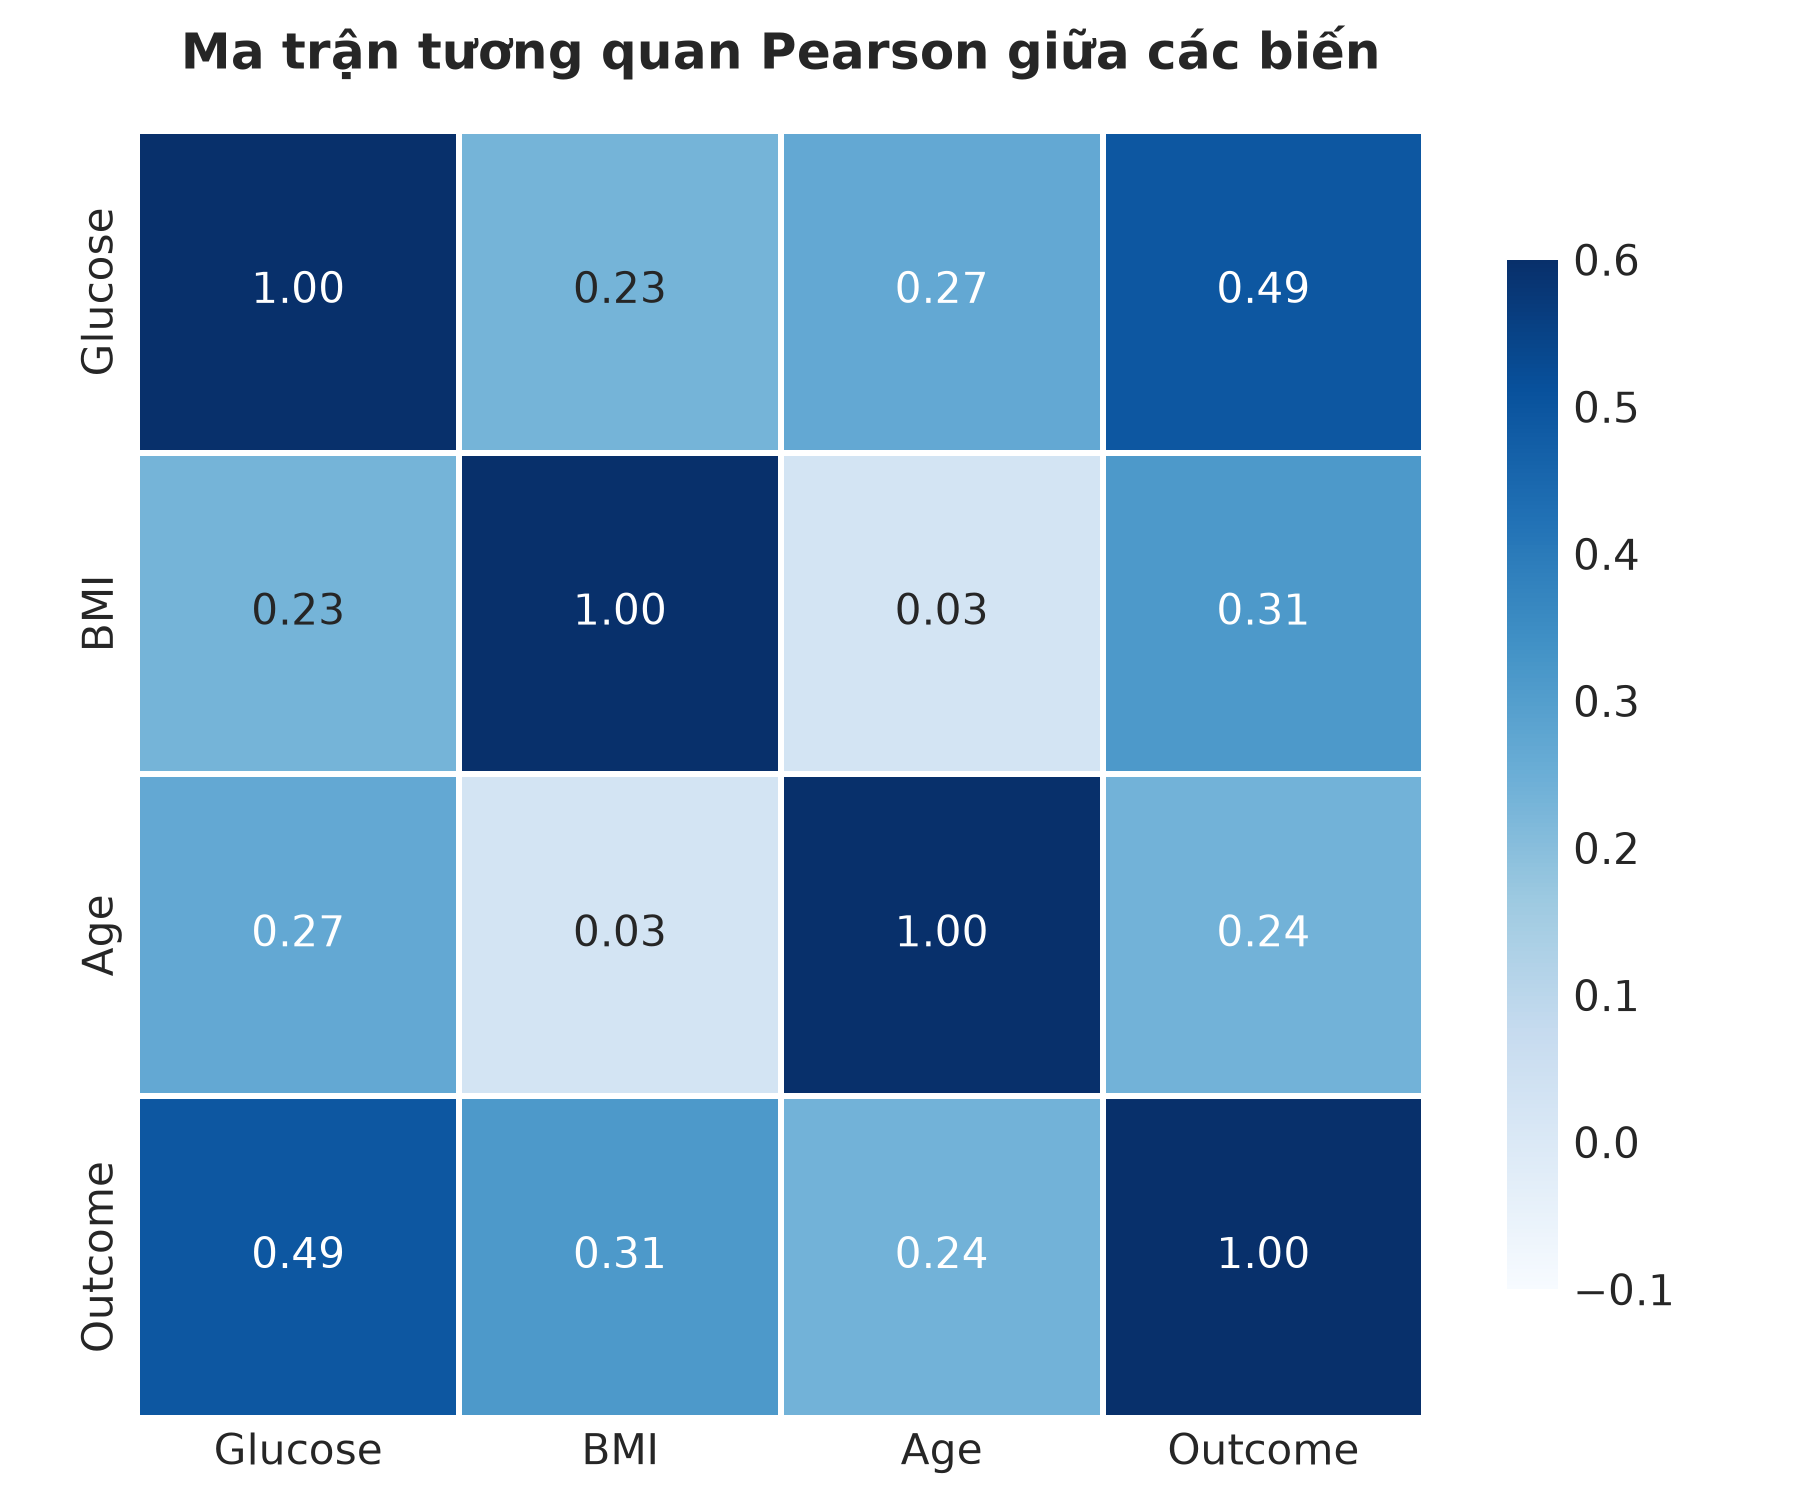
Ma trận tương quan Pearson
4. Tài Liệu RESTful API Backend Flask
Hệ thống cung cấp API JSON để tích hợp dự đoán từ các hệ thống khác:
Tiếp nhận thông tin 3 chỉ số lâm sàng và trả về kết quả dự đoán kèm xác suất.
Ví dụ Payload JSON gửi lên:
{
  "glucose": 145.0,
  "bmi": 28.5,
  "age": 42
}
Ví dụ Response JSON trả về (HTTP 200):
{
  "status": "success",
  "prediction": 1,
  "label": "Nguy cơ tiểu đường (Dương tính)",
  "probabilities": {
    "negative_class_0_pct": 27.5,
    "positive_class_1_pct": 72.5
  },
  "confidence_score_pct": 72.5,
  "disclaimer": "Kết quả chỉ mang tính chất tham khảo học tập..."
}